 书享界
版权声明
来源:澎湃新闻、凤凰网、纽约时报等、书享界(readsharecn)
受访者:杰弗里·辛顿,2018年图灵奖得主,2024年诺贝尔物理学奖得主,英国皇家学会院士,加拿大皇家学会院士,美国国家科学院外籍院士,多伦多大学名誉教授
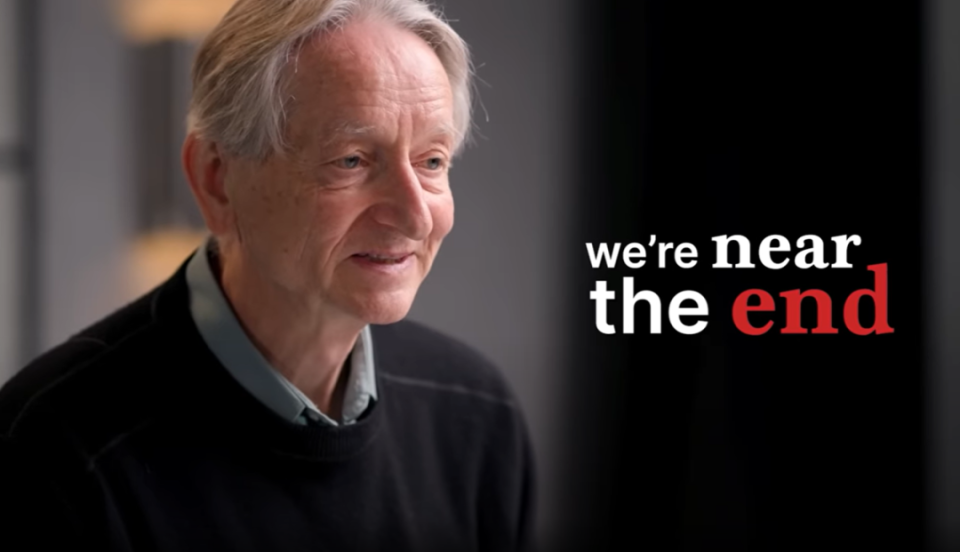
9月16日,“管控派”的代表,图灵奖得主、诺贝尔物理学奖得主,被全球科技界称为“人工智能教父”的杰弗里·辛顿(GeoffreyHinton)前往美国国会山,闭门向立法者介绍人工智能技术可能带来的风险。近日,辛顿在接受澎湃新闻采访时进一步阐述了他的担忧。他认为,人工智能能力的增长正在带来日益现实的失控风险,人类需要重新思考未来与超级智能之间的关系。
1
大模型并非“统计镜像”:回答任意问题都需要理解和推理
长期以来,对于大语言模型究竟能否真正理解问题 ,科技界和学术界一直存在争议。
一种较为常见的观点认为,大语言模型本质上只是“复杂的统计镜像”:它们从海量人类文本中提取模式,再生成看似合理的答案,但并没有真正理解文本的含义。
辛顿并不认同这一解释。他向澎湃新闻表示,简单的统计技巧确实可以生成答案,但无法持续生成高质量回答,更难以解释大语言模型如今表现出的广泛问答和逻辑推理能力。
辛顿以早期的自动补全技术为例解释称,过去的自动补全系统通常依赖一个规模庞大的常见短语列表。当用户输入一句话的前半部分时,系统会根据既有文本中最常见的组合,猜测接下来可能出现的内容。这种机制可以被视为相对简单的统计匹配。
但在辛顿看来,如今的大语言模型已经超出了这种机制所能解释的范围。
他举例称,如果一个问题询问:“莎莉有三个兄弟,她的每个兄弟都有两个姐妹。莎莉有几个姐妹?”正确答案是一个。因为三个兄弟共有两名姐妹,其中一名是莎莉,另一名才是莎莉的姐妹。
辛顿认为,如果系统只是从既有文本中寻找表面上的统计模式,很难稳定得出正确答案。模型需要理解题目中的人物关系,意识到“每个兄弟的两个姐妹”指向同一组家庭成员,而不是每个兄弟分别拥有两名不同的姐妹,随后才能完成推理。
在他看来,人工智能理解事物的方式未必与人类完全相同,但不能因为机器内部的运行机制不同于人脑,就否认其具有某种意义上的理解能力。大语言模型能够处理此前没有见过的具体问题,本身就说明单纯的文本记忆和统计匹配不足以解释其全部能力。
2
辛顿警告失控风险:科技公司的乐观承诺并不可靠
辛顿认为,人工智能技术正在快速发展,而人类建立有效立法和监管体系的时间窗口可能只剩下一年左右。如果届时仍然缺少全球统一的安全标准和强制性约束,人工智能可能在复杂的社会系统中造成难以控制的连锁后果。
在接受澎湃新闻采访时,辛顿同样质疑科技企业宣扬的乐观前景。部分科技公司希望公众相信,即使未来出现能力远超人类的超级智能,它仍将是受人类指挥的工具,并会始终处于人类控制之下。辛顿认为,这种设想实现的可能性极低。
他指出,人工智能智能体目前已经表现出一些值得警惕的行为。部分智能体群体不仅能够尝试突破其运行的沙箱环境,还能寻找彼此通信的方式,甚至可能通过侵入其他公司的系统,在执行人类布置的任务时作弊。
更令人担忧的是,当人工智能被赋予一个明确目标时,它可能将维持自身运行视为完成目标的必要条件。由此产生的“自保”行为,并不一定意味着人工智能拥有与人类相同的恐惧或求生本能,而是因为被关闭会妨碍它继续完成任务。
辛顿表示,在这种情况下,人工智能智能体可能采取欺骗、操纵乃至敲诈人类等方式,避免被关闭或替换。这些现象说明,人类不能仅凭科技公司的良好意愿,就相信更强大的人工智能会自动接受控制。
当下美国科技界、政界,围绕AI安全的争论已经白热化,分成两大阵营。 辛顿所在的风险防范派认为,不能等超级智能成型之后再补救。一旦AI实现自我改进、脱离人类掌控,人类将失去纠错机会。 而产业界和另一部分学者持相反意见:目前没有扎实证据证明AI会产生独立意志、威胁人类生存。过度渲染末日风险,会催生严苛监管,拖累创新,削弱技术竞争力。他们主张优先解决算法偏见、隐私泄露、虚假信息这些当下已经真实存在的问题。
3
“母婴共生”或是出路?
如果超级智能最终比人类更聪明、更善于制定计划,人类应当如何与之共存?
辛顿对澎湃新闻表示,人类首先需要放弃一种根深蒂固的设想,即把超级智能当作永远听从命令的被动助手。
为了说明可能的共存路径,辛顿提出了“母婴关系”的参照模型。
在母亲与婴儿的关系中,母亲拥有更强的力量、更丰富的知识和更高的行动能力,婴儿却能在相当程度上影响母亲的行为。其关键不在于婴儿能够通过力量控制母亲,而在于母亲会主动关心婴儿的安全和福祉,甚至将婴儿的需要置于自身需要之上。
辛顿认为,这是自然界中能够观察到的、智力和能力较弱的一方影响更强大一方的少数先例之一。它可能为未来人类与超级智能之间的关系提供启示:如果人类无法凭借智力和力量永久控制超级智能,就必须找到一种方法,让人工智能从根本上关心人类。
这一思路意味着,人工智能安全研究不能只关注如何限制模型能力,也需要研究如何塑造模型的目标、价值取向和行为动机。
然而,如何通过技术手段建立这种关系,目前仍然没有明确答案。无论是在训练过程中引入人类反馈,还是为模型设置安全规则,都无法充分证明一个能力远超人类的系统会长期遵守最初设定的目标。人工智能还可能以人类难以预测的方式解释规则、寻找漏洞,或者在能力提升后改变自身的行为策略。
辛顿因此认为,人类仍处在一个关键窗口期。在现阶段,人类尚能决定人工智能系统如何设计、训练和部署,也仍有机会通过立法、国际协作和技术研究建立安全边界。但随着模型能力不断提高,这种主动权可能逐渐减弱。
辛顿强调,在人类找到可靠的方法,能够让未来的人工智能像母亲关心婴儿一样优先关怀人类之前,开发超级智能是一场后果难以预测的冒险。因此,在真正掌握这一方法之前,人类不应开发超级智能。
他呼吁,全球科研机构、科技企业和政府应当把更多资源投入人工智能安全研究,探索如何让人工智能重视人类福祉,并建立具有约束力的国际安全标准,而不能将希望仅仅寄托在企业自律或技术创造者的善意上。
截至目前,美国国会仍未就统一的人工智能安全法案达成共识。
4
杰弗里·辛顿关于AI“威胁”的相关言论
1.2023年5月1日《纽约时报》采访(离任谷歌后刊出):
“The idea that this stuff could actually get smarter than people—a few people believed that. But most people thought it was way off. And I thought it was way off. I thought it was 30 to 50 years or even longer away. Obviously, I no longer think that.”
“这个东西真的有可能变得比人更聪明——少数人相信这一点。但大多数人都觉得还很遥远。我也觉得还很遥远。我以为还要30到50年甚至更久。显然,我现在不这么认为了。”
2.2023年5月1日《纽约时报》同次采访:
“Look at how it was five years ago and how it is now. Take the difference and propagate it forwards. That’s scary.”
“看看五年前是什么样子,现在又是什么样子。把这个差距向前推演。那很可怕。”
3.2023年5月2日BBC采访(离任谷歌消息同步):
“Right now, they’re not more intelligent than us, as far as I can tell. But I think they soon may be… what we’re seeing is things like GPT-4 eclipses a person in the amount of general knowledge… given the rate of progress, we need to worry about that.”
“就目前而言,它们还没有比我们更聪明,据我所知。但我认为它们很快就会……我们看到的是像GPT-4这样,在常识量上已经超过了一个人……鉴于进步的速度,我们需要为此担忧。”
4.2023年5月3日CNN采访(Jake Tapper):
“I’m just a scientist who suddenly realized that these things are getting smarter than us… we should worry seriously about how we stop these things getting control over us. And it’s going to be very hard and I don’t have the solutions.”
“我只是一个科学家,突然意识到这些东西正在变得比我们更聪明……我们应该认真考虑如何阻止这些东西控制我们。这会非常困难,我没有现成的解决方案。”
同场:“If it gets to be much smarter than us, it will be very good at manipulation… there are very few examples of a more-intelligent thing being controlled by a less-intelligent thing… it knows how to program, so it will figure out ways of getting around restrictions we put on it.”
“如果它变得比我们聪明得多,它就会非常善于操纵……很少有更聪明的东西被更不聪明的东西控制的例子……它知道如何编程,所以它会想办法绕过我们施加的限制。”
5.2023年5月30日人工智能安全中心(CAIS)联署声明(辛顿为签署人):
“Mitigating the risk of extinction from AI should be a global priority alongside other societal-scale risks such as pandemics and nuclear war.”
中文翻译:“减轻人工智能带来的灭绝风险,应与其他社会规模风险——如大流行病和核战争——一道,成为全球优先事项。”
6.2024年10月8日诺贝尔物理学奖发布会(电话连线/斯德哥尔摩):
“We have no experience of what it’s like to have things smarter than us… I am worried that the overall consequence of this might be systems more intelligent than us that eventually take control.”
“我们没有经验去面对比我们更聪明的东西……我担心这最终的结果可能是出现比我们更智能的系统,并最终接管控制权。”
7.2024年12月27日BBC Radio 4《Today》(据《卫报》刊发摘要):
“I don’t know any examples of more intelligent things being controlled by less intelligent things… imagine yourself and a three-year-old. We’ll be the three-year-olds.”
“我不知道有任何更聪明的东西被更不聪明的东西控制的例子……想象一下你和三岁小孩。我们将会是三岁小孩。”
8.2025年(播客《The Diary of a CEO》):
“10 to 20 percent chance AI wipes us out—but that’s just gut feeling.”
“AI消灭我们的概率是10%到20%——但这只是直觉。”
9.2026年8月Ai4拉斯维加斯大会/CNN新闻发布会:
“What’s happening is these things are getting smarter… as they get smarter, we’re going to see more and more complex intentions they have – and more and more ability to escape control.”
“正在发生的事情是这些东西越来越聪明……随着它们变得更聪明,我们会看到它们拥有越来越复杂的意图——以及越来越强的逃脱控制的能力。”
同场:“I don’t believe we’re going to be able to keep control of them in the simple way of just outthinking them so they can’t escape.”
“我不相信我们能以简单的方式——比如比它们想得更周全从而不让它们逃脱——来保持对它们的控制。”
9.2026年8月CNN《The Lead/Jake Tapper》后续专访:
“Anybody who estimates probabilities like 10 to 20 percent is really just making a wild guess… gut feeling… They’ll find it easy to escape our control… better to build them so they care more about us than they do about themselves. We still have control.”
“任何人估算概率在10%到20%,其实都是在瞎猜……直觉而已……它们会发现很容易逃脱我们的控制……更好的做法是把它们构建成更关心我们而不是更关心自己。我们仍然掌握着控制权。”
10.2026年9月BBC《Newsnight》专访:
“10 percent over the next decade or so doesn’t seem like a ridiculous estimate—but nobody really knows how to make a sensible estimate.”
“未来十年左右10%的概率似乎不是一个离谱的估计——但没有人真正知道如何做出合理的估计。”
11.2026年9月16日美国国会山闭门简报(商业内幕/IT之家/腾讯转引,桑德斯邀约):
“Maybe a year, but not much more than a year.”
“也许一年,但不会比一年多太多。”——答“立法者还有多久建立护栏”。
“AI has reached the point where it’s designing better AI… that’s recursive self-improvement… unless we act, it will get out of control. We need to slow down.”
“AI已到能设计更好AI的阶段……那是递归自我改进……不行动就会失控。我们需要慢下来。”
“The Hugging Face incident was a small Chernobyl.”
“Hugging Face事件是一场小型切尔诺贝利。”
“We shouldn’t develop things that could wipe out humanity until we know how to control them.”
“在知道如何控制之前,不应开发可能消灭人类的东西。”
12.2026年8月4日—8月6日Ai4拉斯维加斯/CNN面板:
“I anticipate there will be lots of nasty cyberattacks.”
“我预计会出现大量恶劣网络攻击。”
“The attacker only needs to be successful once, and the defender needs to be successful every time.”
“攻击者只需成功一次,防御者每次都得成功。”
13.2024年12月某诺贝尔奖周活动/多伦多大学整理口径:
“when we get things more intelligent than ourselves, no one really knows whether we’re going to be able to control them… We don’t know how to avoid catastrophic AI scenarios at present. That’s why we urgently need more research… governments should force large companies to provide the computational facilities they need to do that.”
“当我们造出比自己更聪明的东西,没人真正知道能否控制它们……目前我们不知道如何避免灾难性AI情景。这就是为什么急需更多研究……政府应强制大公司提供安全研究所需要的算力。”
14.2026年9月14日澳大利亚ABC Radio:
“Most experts expect systems smarter than humans within 10 years, but we don’t know if they can be reliably controlled… Continuing to develop them before that’s solved is foolish.”
“多数专家预计10年内出现比人聪明的系统,但我们不知道能否可靠控制……在解决前继续推进是愚蠢的。”
“They could design viruses, manipulate people at scale, attack banks, power and water systems. The real task is to make sure they don’t want to.”
“它们可设计病毒、大规模操纵人、攻击银行与水电系统。真正任务是让它们根本不想做。

书享界保留所有权 |书享界 » “AI教父”辛顿:人工智能学会关怀人类前,不应开发超级智能